1つのタスク、2つのモデル、同じエージェント
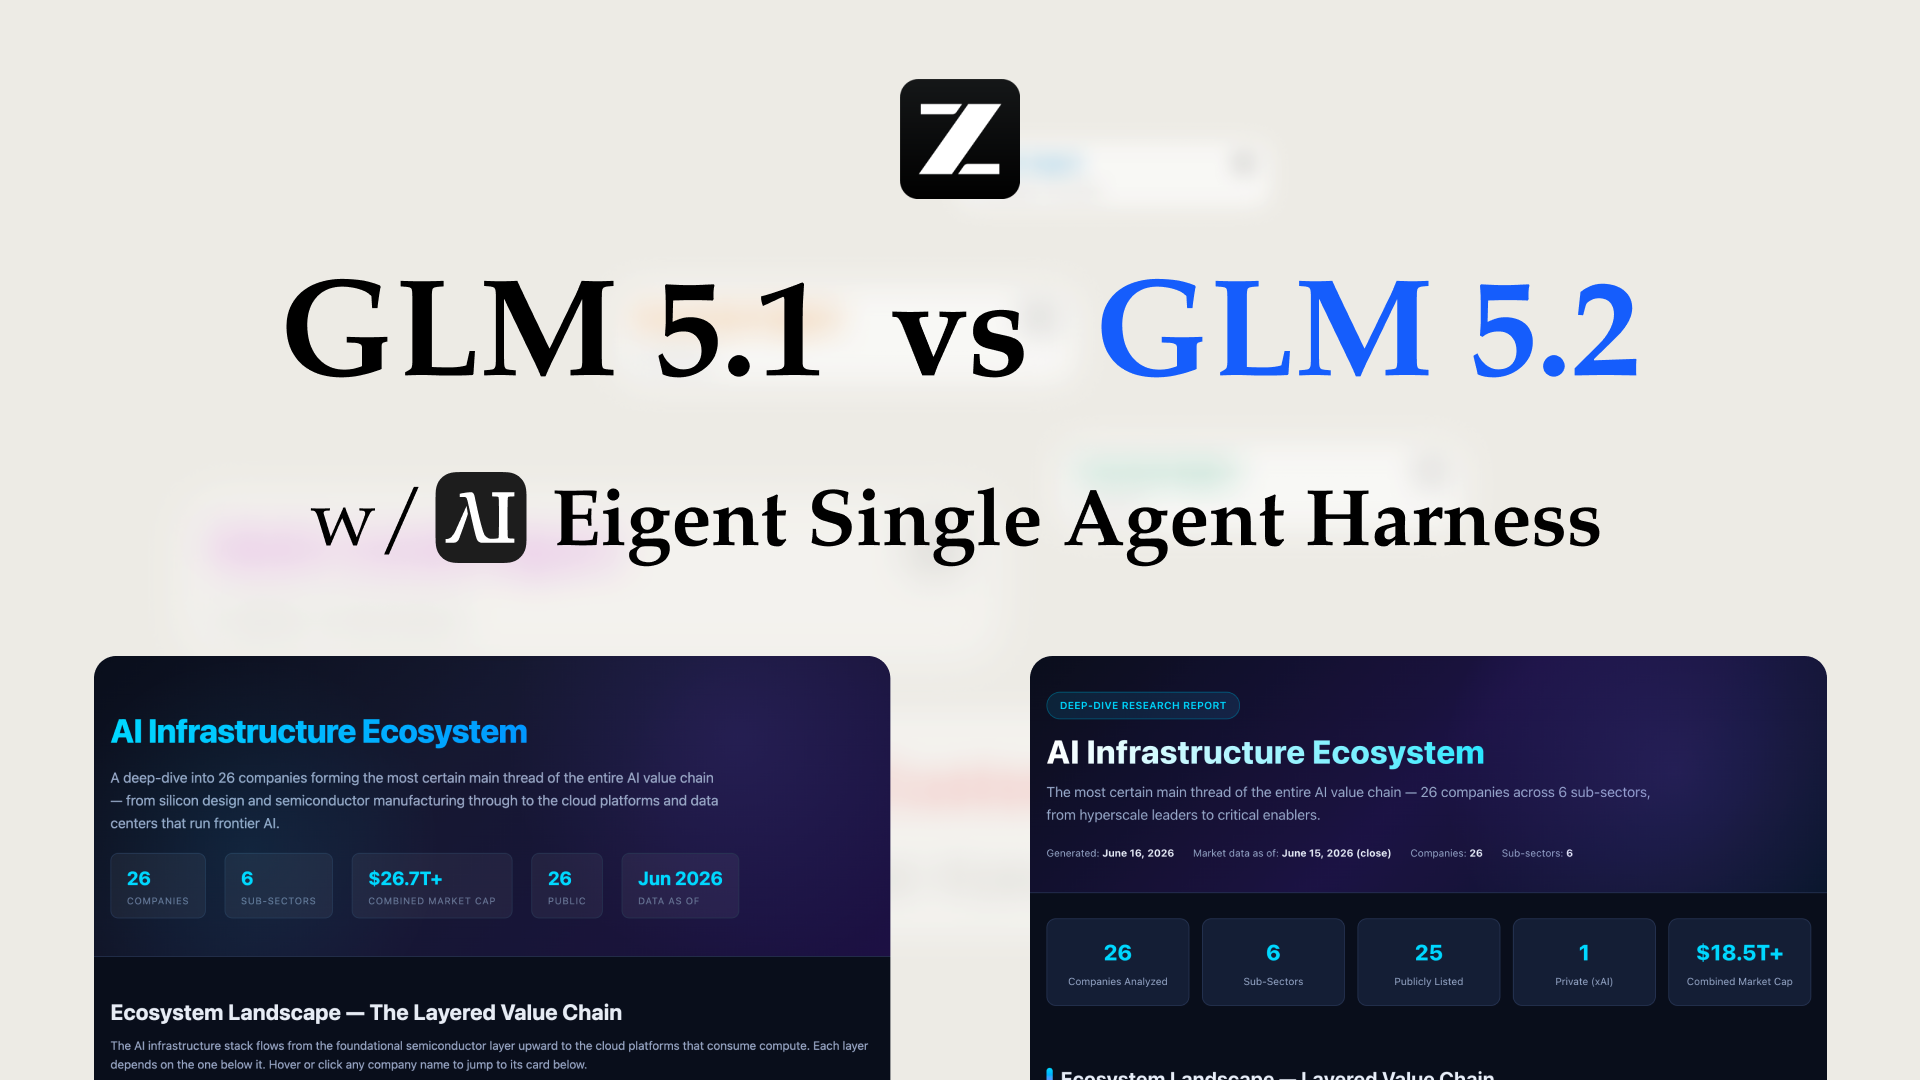
2つのモデルを比較する最もきれいな方法は、他の条件を一切変えないことです。そこで私たちはまさにそれを行いました。同じ長期タスク、同じエージェント、同じツールです。GLM-5.1 と GLM-5.2 に、Eigentの シングルエージェントハーネス 内で同一の依頼を与え、それぞれがどのように計画し、調査し、検証し、納品するかを観察しました。
課題は、おもちゃのベンチマークではなく、実際のアナリスト業務でした。
AIインフラスタック全体にわたる26社を調査する。シリコン設計や半導体製造から、最先端AIを支えるクラウドプラットフォームやデータセンターまでを含み、さらにインタラクティブレポートを作成する。
このような長期タスクでは、モデルの差が本当に現れます。1つの賢い回答ではなく、長い実行の中で連なる何十もの小さな判断が問われるのです。どこまで計画を深めるか、どれだけのソースを信頼するか、いつ調査を止めるか、完了と宣言する前にどこまで検証するか。
プロンプト
両方の実行に、同じプロンプトを シングルエージェントモード で送信しました。
AIバリューチェーン全体の中でも最も確度の高い主軸である、AIインフラ・エコシステムに属する26社について深掘り調査を行ってください。以下の6つのサブセクターを網羅してください(各分野で、大手リーダーから中小企業まで代表的な企業を選んでください):
- AIデータセンター(計算基盤/建設拡大)
- GPU/AIチップ(学習・推論向けシリコン、ASIC、IP)
- サーバー、ネットワーキング&光学モジュール(スイッチ、NIC、光インターコネクト)
- 電力、液冷&エネルギー貯蔵(電源、熱管理、エネルギー管理)
- AIクラウド/計算プラットフォーム(ハイパースケーラー、GPUクラウド、計算リースプラットフォーム)
- 支援エコシステム(HBM/先端パッケージング、ファウンドリ、コネクタ、その他重要部品)
各社について調査してください: 企業名、サブセクター、本社/国;主要製品とAIチェーンにおける具体的役割;上場または非上場(上場企業はティッカー+取引所、非上場企業は最新の評価額/資金調達ラウンドを記載);時価総額または評価額(順位付けに使用);エコシステム内でのポジショニングと参入障壁(1〜2文);主要顧客/競合。
各サブセクター内では、大きい順から小さい順に企業を順位付けし、全体をトップダウンで構成してください。ハードウェア・エコシステム全体の概観から各企業個別の詳細へと落とし込んでください。
出力: まず、26社すべて、6つのサブセクター分類、上場・非上場フラグ、サブセクター横断の比較マトリクスを含む構造化 ai_infra_data.json を生成してください。次に、そのJSONから洗練されたインタラクティブHTMLレポートを生成してください。レポートには、エコシステムの概観図、セクション別構成、企業カード、上場・非上場の色分け、時価総額ランキングチャート、並び替え/絞り込み可能な比較テーブルを含めてください。まず調査データの正確性を検証し(上場状況、ティッカー、評価額 — 最新数値、出典を使用)、その後にレポートを生成してください。
実行準備 — GLM-5.2はより深く計画する
最初の分岐は、どちらのモデルもウェブに触れる前、つまり計画の段階で現れました。
GLM-5.1は作業を 4ステップ に分解しました。GLM-5.2は同じ依頼を 6ステップ にまで विस्तげ、しかも注目すべきことに、「正確性の検証」そのものを独立したタスク にして、ついでの作業にはしませんでした。これは慎重なアナリストが仕事を設計するときのやり方です。まず調査し、次にその調査を証明し、それから構築する。
指示は同じ。違ったのは、そのタスクにどれだけの厳密さを求めるかという判断です。
調査 — ソース数は2倍
計画は、まったく異なる調査実行へとつながりました。
- GLM-5.1: 約 40ソース
- GLM-5.2: 約 82ソース — 調査量はおよそ 2倍
しかも、単にページ数が 多い だけではなく、分散のよい ページでした。GLM-5.1が単一のデータサイトに大きく依存していたのに対し、GLM-5.2は各数値を 金融ニュース、企業開示、プライベート市場データベース でクロスチェックしました。Reuters、Bloomberg、Crunchbase、TechCrunch などです。
ソースは1つでは不十分です。評価額、ティッカー、上場状況について、GLM-5.2は1つの数値を事実としてコピーするのではなく、確認すべき仮説として扱いました。
GLM-5.2は単に速く答えたのではありません。2倍のページを使ってあらゆる数値を検証し、より深く掘り下げました。
終了前に検証する
GLM-5.2は検証を独立したステップとして切り出していたため、実際にそれをやり切りました。上場状況、ティッカー、評価額を、レポートに反映する前に最新数値と照合し直したのです。その結果、これは主張するだけのレポートではなく、作業を証明するレポート になりました。
結果 — より深いデータ、実在の引用
同じタスクでも、成果物はまったく違いました。
GLM-5.2が出力したのは:
- より豊かなデータスキーマ。専用の moat分析、資金調達の詳細、そして 完全なソース一覧 を備え、すべての主張が出典まで追跡可能。
- データ面でも構成面でも、GLM-5.1より ほぼ2倍充実 した最終レポート。
- 静的なHTMLページではなく、完全にデプロイ可能なインタラクティブサイト として出力。エコシステム概観図、セクション別構成、上場・非上場の色分け、時価総額ランキングチャート、並び替え/絞り込み可能な比較テーブルを含む。
GLM-5.1は堅実で正確なレポートを出しました。GLM-5.2は、投資委員会にそのまま提出できるレポートを出しました。
これが重要な理由
短いタスクでは、2つの高性能モデルはほとんど同じに見えます。しかし、長期タスク では差が積み重なります。GLM-5.2が追加で読んだソース、二重確認した数値、そして検証を最優先のステップにした判断——そのすべてが積み上がり、測定可能なほど良い結果につながりました。
ハーネスは同じでした。ツールも同じでした。変数はモデルだけです。だからこそ、これはGLM-5.2が長い実行の中でどのように推論するかを公平に見るための読み解きになります。
より多くのソース。より鋭い判断。作業を証明するレポート。
自分で試す
Eigentでは、同じシングルエージェントハーネスの背後にあるモデルを切り替えられるので、まったく同じ比較を自分のタスクで実行できます。
- 設定 → モデル に移動し、テストしたいモデル(GLM-5.1、GLM-5.2、または任意の function-calling model)を選択または追加します。
- タスクを シングルエージェントモード に切り替えます。
- 上の深掘り調査プロンプト(または自分の長期タスク用ブリーフ)を貼り付けます。
- モデルごとに1回ずつ送信し、計画、ソース数、最終レポートを並べて比較します。
次に試すこと
同じブリーフを再実行し、評価額については少なくとも3つの独立したソースを必須にし、ソース間で不一致がある企業をフラグ付けする。
対象を26社から50社に拡大し、比較マトリクスに「サプライチェーン依存度」列を追加する。
最終レポートの1ページ経営層向け要約をPDFで生成し、さらに時価総額ランキングチャートのスライドデッキも作成する。
GLM-5.2を同じタスクで別のモデルと競わせ、差分レポートを作成する。どこで一致し、どこで不一致があり、どちらのソーシングが優れていたかを示す。
より良い結果のためのヒント
- 検証を明示する。 モデルに「まず正確性を検証し、その後に構築する」と求めるだけで行動は測定可能に変わります。GLM-5.2はその一文を独立した計画ステップへと変えました。
- スキーマに引用元を必須化する。 各企業に
sourcesフィールドを要求すると、自信ありげな推測ではなく、追跡可能な調査を強制できます。 - データと表現を分ける。
ai_infra_data.jsonを 先に 生成してからHTMLを作ることで、レポートの再生成性と事実の監査可能性が高まります。 - 長期推論ではシングルエージェントモードを使う。 すべてのタスクコンテキストを1つのモデルに持たせられるため、長い実行の中でモデルがどのように計画し、自力で修正するかを比較するには最適です。